Migration ETL - de l'ETL legacy vers un ETL SQL ouvert - {oa-tbx}
Une fois convertis en SQL par {openAudit}, les traitements ETL s’exécutent dans le conteneur {oa-tbx}, indépendamment de la plateforme ETL d’origine. {oa-tbx} exécute des traitements SQL, Python ou Java, pilotés par des référentiels de configuration et d’orchestration.
Principes
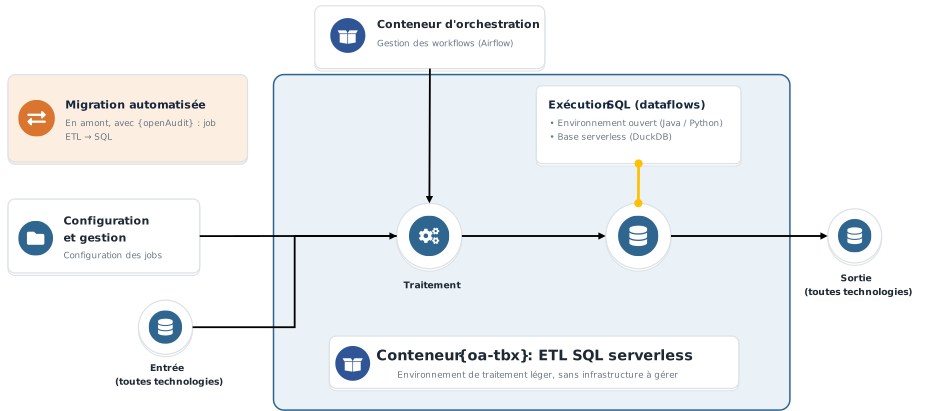
Le SQL est encapsulé dans des conteneurs ouverts, en mode ETL.
- Des conteneurs : les transformations s’exécutent dans un conteneur externe, {oa-tbx}, détaché de la base de données cible. Des conteneurs temporaires servent de zones de stockage intermédiaires où les données sont chargées avant transformation. Les jobs, et le cas échéant les données, sont testés pour garantir leur intégrité.
- Orchestration avec Airflow : Airflow pilote l’exécution des conteneurs, étape par étape ; chaque transformation est définie comme un job. Le scheduling migré reprend automatiquement l’ensemble des instructions et de l’ordonnancement d’origine.
Chaîne d’exécution
Les traitements produits par {openAudit} sont intégrés dans un référentiel de configuration et un référentiel de pilotage utilisés par {oa-tbx}, puis orchestrés par des outils tels qu’Airflow ou Dagster. L’orchestration (dépendances, paramètres d’exécution, planifications, déclenchements) reste séparée des traitements métier, contenus dans les scripts SQL et les dataflows.
Conteneur d’exécution
Les dataflows peuvent combiner SQL, Python, Java ou d’autres langages. Le moteur peut s’appuyer sur des bases embarquées telles que DuckDB pour certains traitements intermédiaires.
Sources et cibles
Les données d’entrée proviennent de toute technologie accessible en SQL ou JDBC ; les résultats sont chargés vers tout système compatible avec les mécanismes d’écriture standards.
Bénéfices
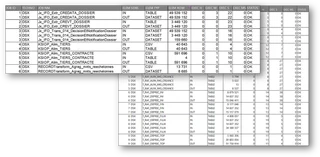
Les pipelines SQL sont ouverts et indépendants des runtimes propriétaires des plateformes Cloud. Sur l’ensemble des jobs migrés (de quelques milliers à plus de 50 millions de lignes), les temps d’exécution se comptent souvent en secondes, avec un statut OK quasi systématique.
Gouvernance et data lineage
{oa-tbx} conserve la trace complète entre la logique ETL d’origine et le SQL exécuté, sur deux niveaux de lecture.
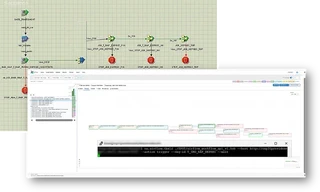
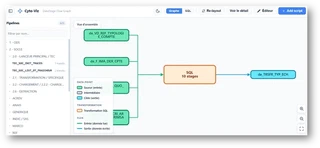
Vue high level du pipeline : seules les tables source et cible sont visibles ; les stages ETL intermédiaires sont regroupés en un bloc SQL unique, lisible même sur des pipelines complexes.
Détail au clic sur une transformation : au clic sur un stage (par exemple un Transformer), son équivalent SQL s’affiche, avec ses inputs/outputs et ses métadonnées d’origine (type, stage ID).
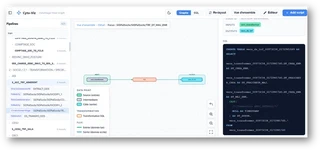
Résultat : une chaîne ETL/ELT basée sur le SQL, ouverte et versionnable, gouvernée de la vue d’ensemble jusqu’au SQL exécuté, quelle que soit la plateforme ETL d’origine.