Migration ETL - connecteurs ETL legacy pour migration SQL
Les plateformes ETL reposent sur des connecteurs, des composants de transformation, des mécanismes de paramétrage et des stratégies d’exécution propres à chaque éditeur.
{openAudit} analyse ces composants, reconstruit leur comportement puis génère une représentation SQL indépendante de la technologie source.
Point clé : la conversion repose sur l’analyse des composants ETL et non sur une simple traduction syntaxique.
Analyse des composants
Les référentiels techniques sont analysés pour identifier les connecteurs, les transformations, les paramètres, les dépendances et les mécanismes d’exécution.
Les composants sont convertis vers un modèle intermédiaire commun avant génération SQL.
Cette approche est identique quelle que soit la technologie source.
Connecteurs
Les connecteurs de lecture et d’écriture sont analysés pour reconstruire les flux entre les systèmes.
Les paramètres de connexion, les requêtes, les formats de données et les mappings sont intégrés dans le modèle de migration.
Les flux peuvent provenir de bases relationnelles, de fichiers, d’APIs ou de plateformes Cloud.
Usage typique : reconstruction des échanges entre Oracle, SQL Server, PostgreSQL, fichiers plats ou stockages Cloud.
Transformations
Les composants de transformation sont convertis en instructions SQL.
Filtres, jointures, agrégations, lookups, mappings, conversions de types, calculs de colonnes et expressions conditionnelles sont reconstruits dans le modèle SQL cible.
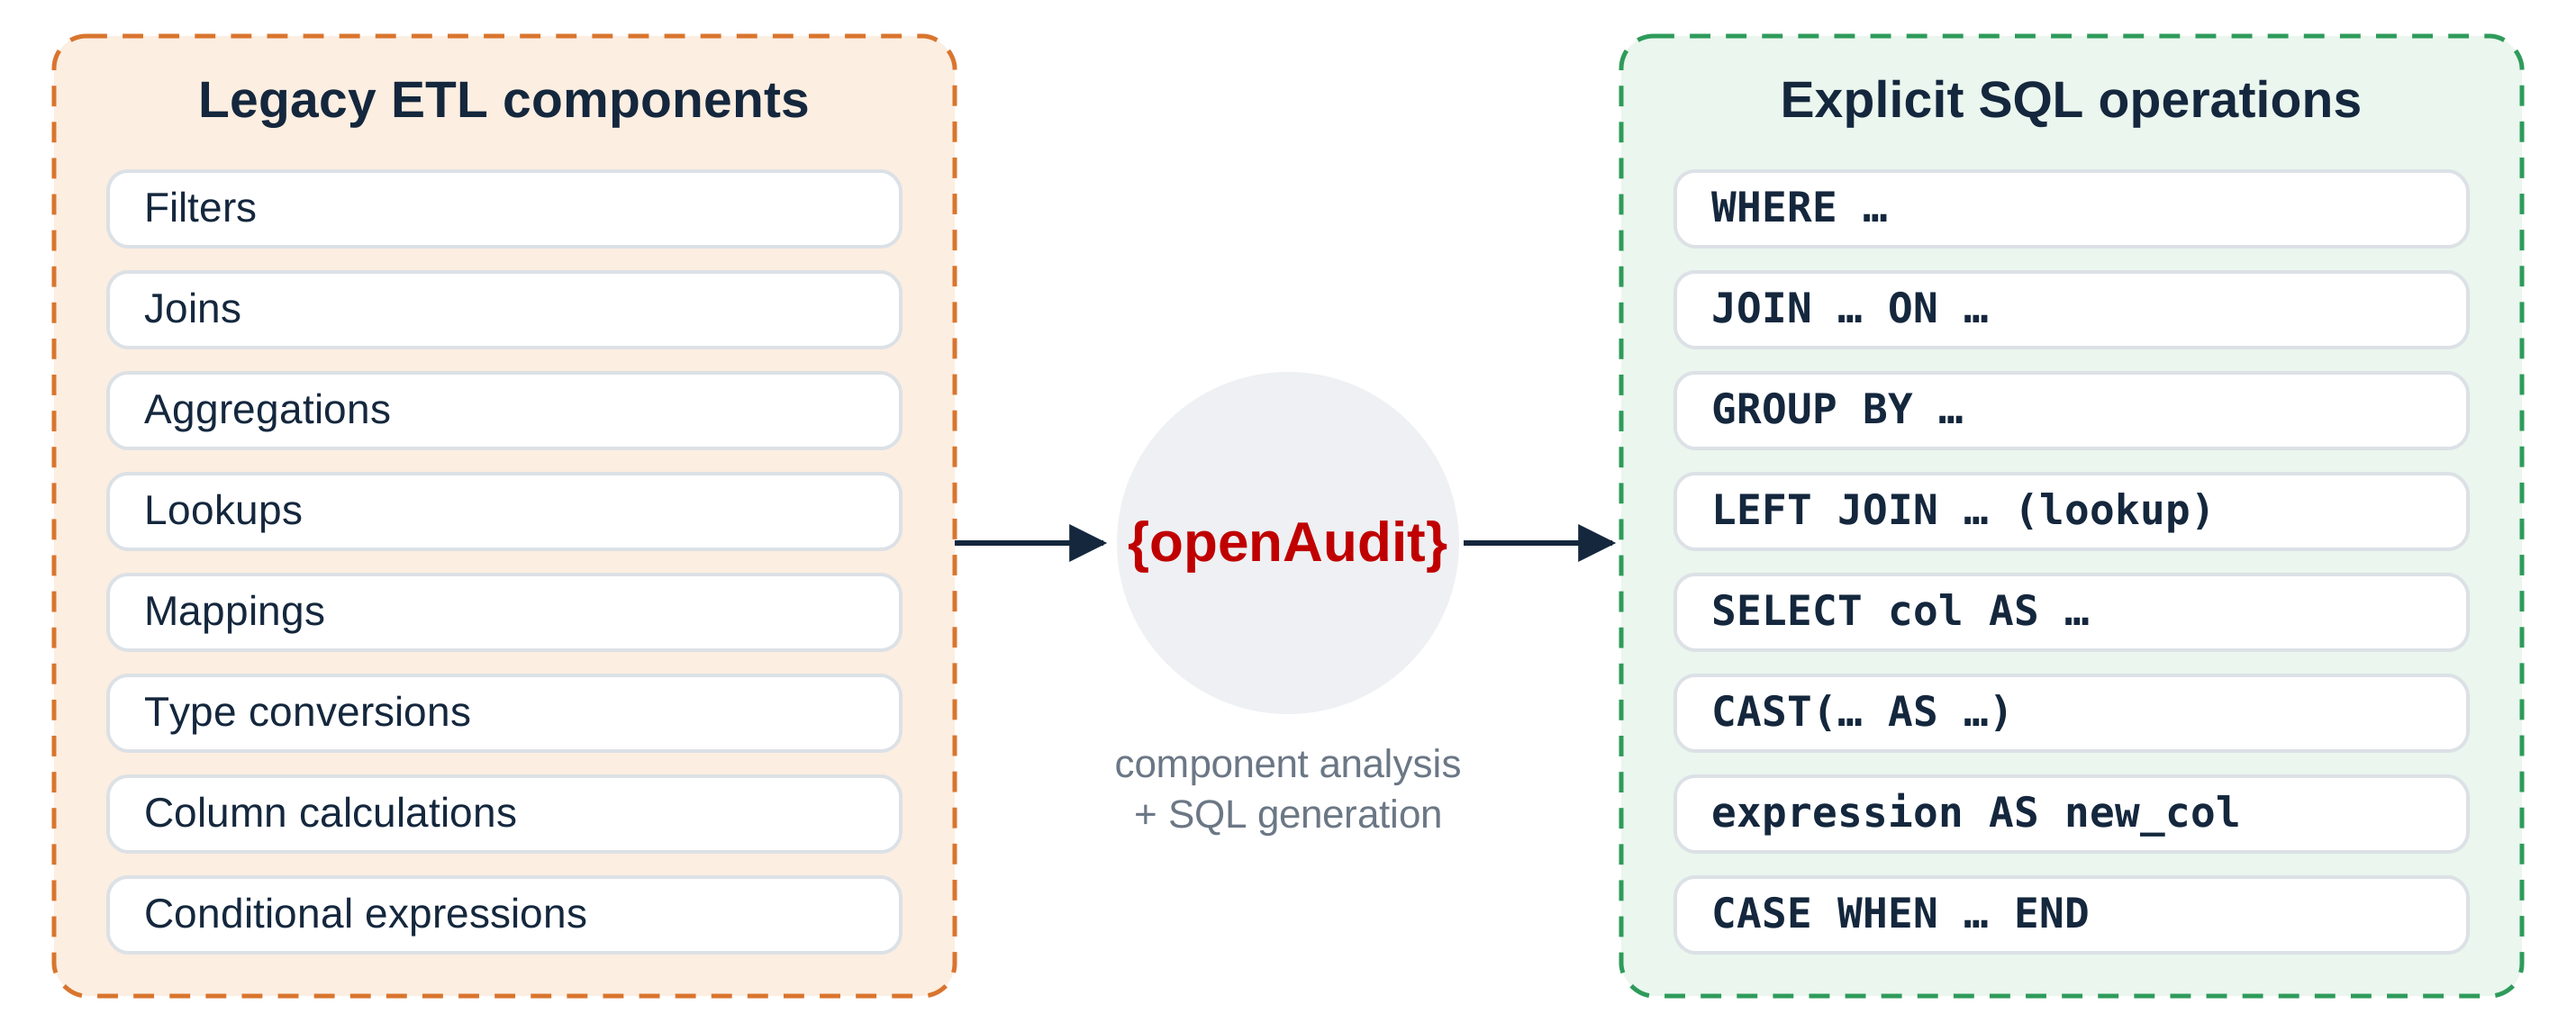
Point clé : chaque transformation devient une opération SQL explicite.
Paramétrage
Les variables d’environnement, paramètres de jobs, bibliothèques partagées et composants réutilisables sont analysés pendant la conversion.
Les dépendances entre traitements et les mécanismes de paramétrage sont conservés dans le modèle généré.
Technologies supportées
Les moteurs de migration couvrent notamment :
La méthodologie reste identique : analyse des composants, reconstruction des flux puis génération SQL.
Résultat : une approche homogène appliquée à des technologies ETL différentes.
SQL comme format pivot
Une fois les composants reconstruits, les traitements sont convertis vers un modèle SQL indépendant de la plateforme source.
Le SQL généré peut ensuite être adapté à Snowflake, BigQuery, Databricks SQL, Redshift, PostgreSQL, SQL Server ou tout autre moteur compatible.
Point clé : le SQL devient le format commun de représentation des traitements.
{oa-tbx} : la cible recommandée
Réécrire des jobs DataStage, PowerCenter, BODS, Talend, ODI ou SSIS dans un autre ETL propriétaire, c’est reconduire les licences, l’infrastructure dédiée et le lock-in éditeur.
{oa-tbx} est un ETL SQL open source et serverless, avec moteur DuckDB embarqué. Les jobs transcrits automatiquement en SQL par {openAudit} y sont exécutés sous forme de pipelines orchestrés par Airflow, sans infrastructure dédiée.
Le SQL produit par les connecteurs est directement exécutable dans {oa-tbx}.
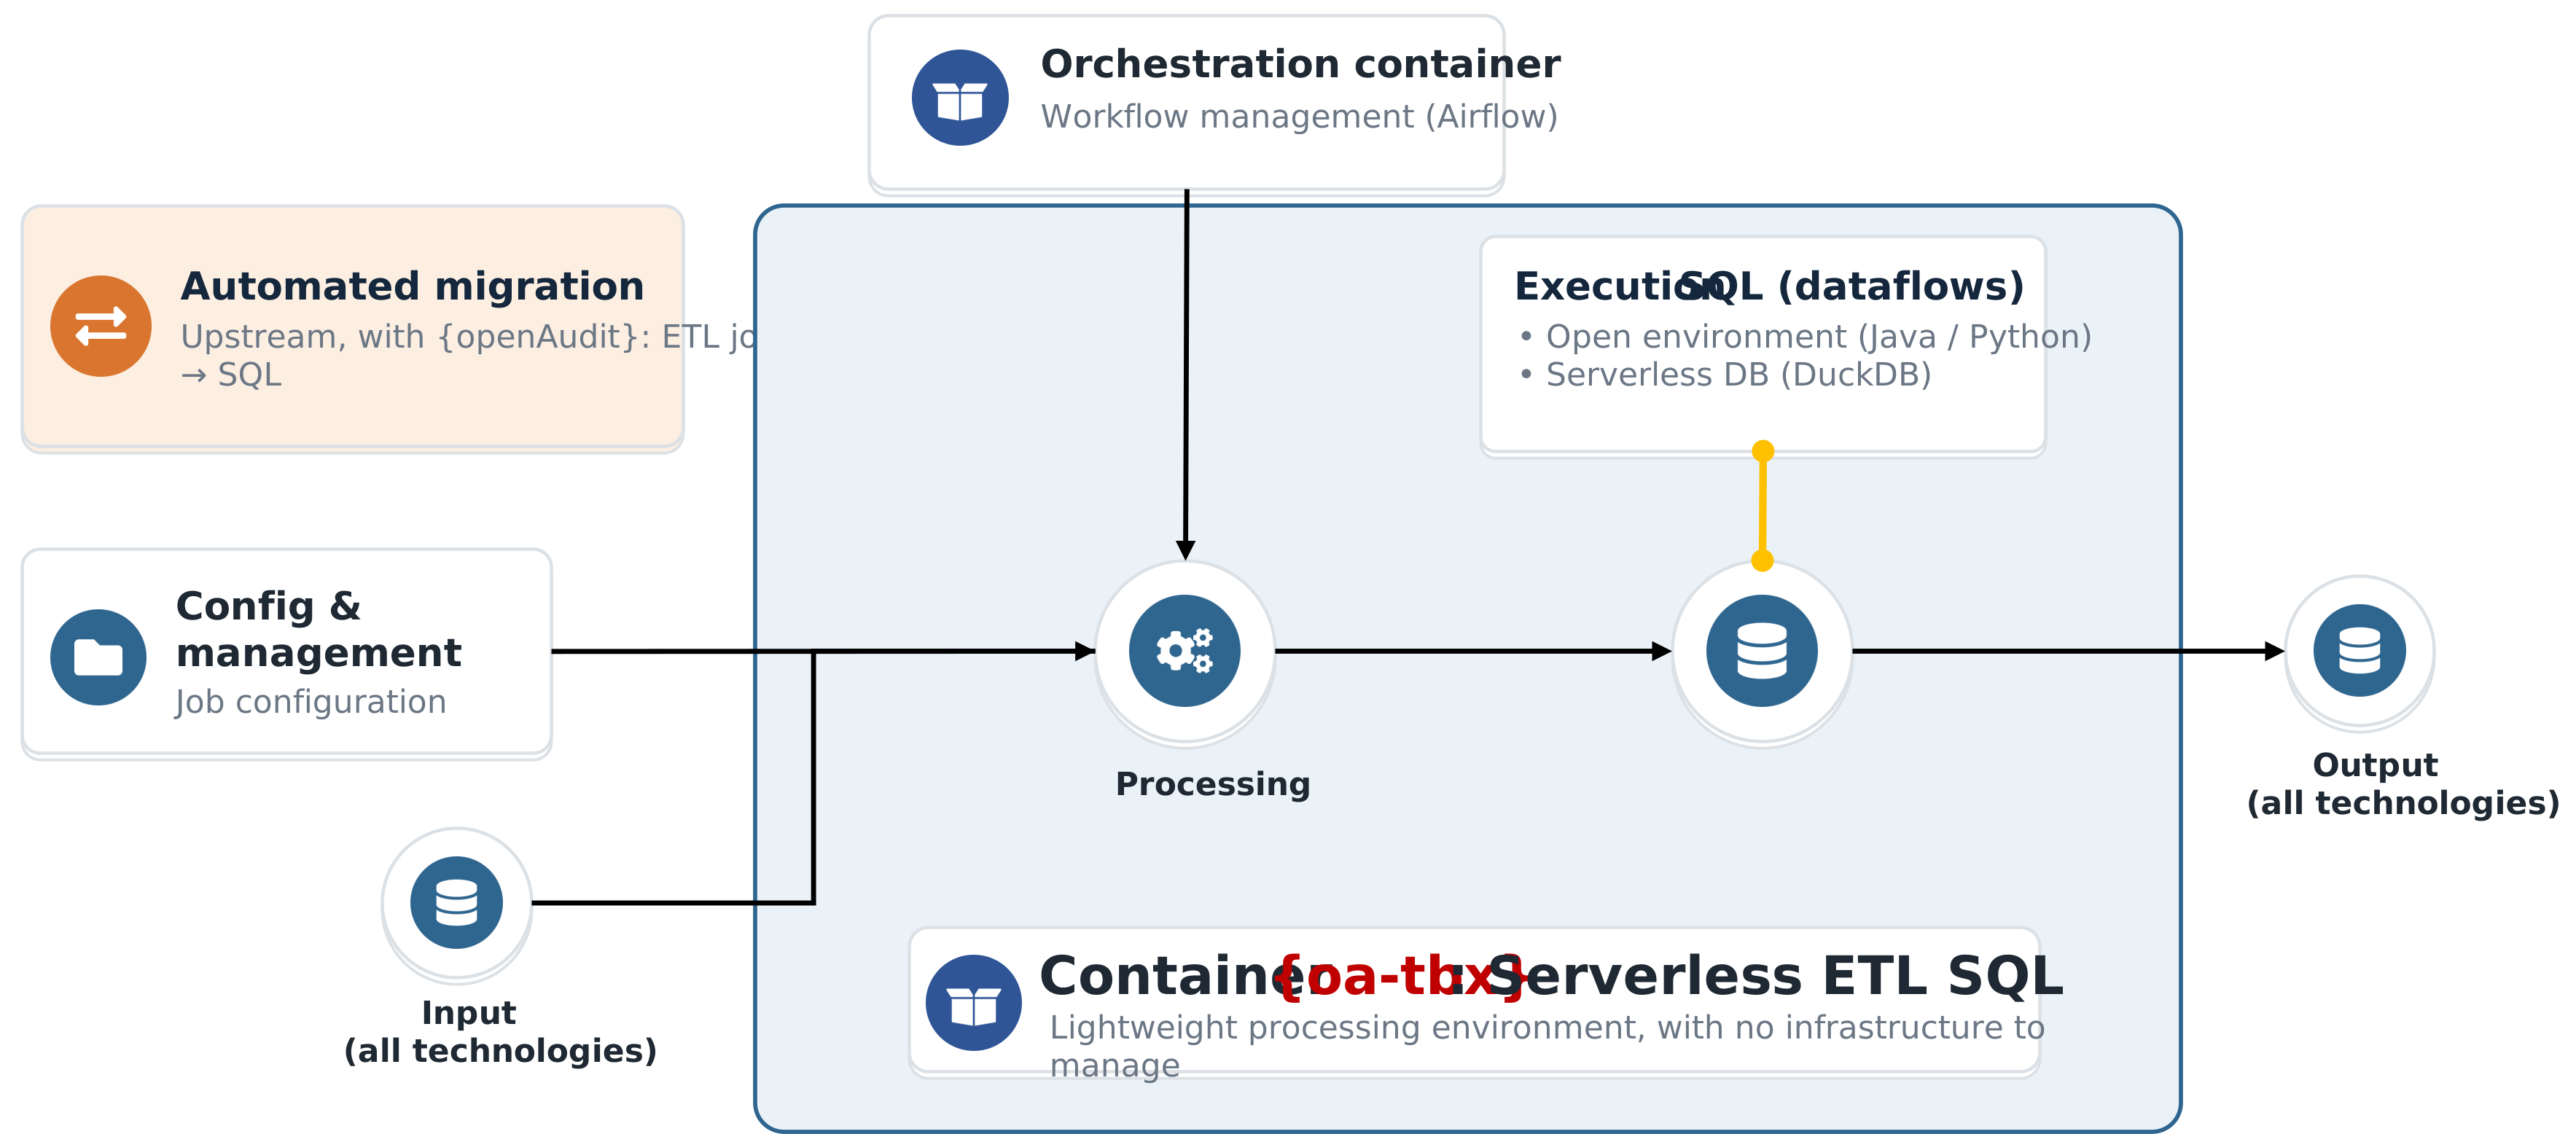
- Transcription automatique : {openAudit} convertit les jobs legacy en SQL à plat, sans des mois de reverse engineering.
- Orchestration ouverte : la séquence de jobs de l’ETL source est reprise à l’identique sous forme de DAG Airflow.
- DuckDB embarqué : moteur SQL analytique open source, sans serveur à administrer ; des jobs de quelques milliers à plus de 50 millions de lignes s’exécutent souvent en quelques secondes.
- Pipeline as Code : jobs SQL et DAG Airflow en Python, versionnés dans Git et déployés par Terraform.
- Gouvernance par le data lineage : chaque transformation d’origine reste reliée au SQL réellement exécuté.
- Zéro lock-in : conteneurisé, Java / Python, aucune licence ni roadmap propriétaire.
Point clé : avec {oa-tbx}, les flux migrés deviennent du SQL ouvert, lisible et auditable ligne à ligne, exécutable sur tout environnement.
Découvrir {oa-tbx} → · La migration ETL vers {oa-tbx} en détail →
