Migration DataViz - interopérabilité SQL et couche sémantique - {oa-lake}
Les plateformes décisionnelles combinent souvent plusieurs bases de données, data warehouses / data lakes et outils de restitution. Elles s’appuient aussi sur une couche sémantique : les utilisateurs manipulent des objets métier (« clients », « contrats », « chiffre d’affaires ») plutôt que des tables ou du SQL.
{oa-lake} réunit les deux dans un même middleware :
- une couche d’interopérabilité SQL entre les sources de données et les outils de datavisualisation, qui fédère les requêtes et exécute les traitements (mini pipelines SQL) ;
- une couche sémantique intégrée : objets métier, dimensions, mesures, KPI, règles de calcul et sécurité, définis une seule fois pour tous les outils.
Point clé : sources et outils de restitution deviennent indépendants ; les structures physiques restent masquées.
Architecture
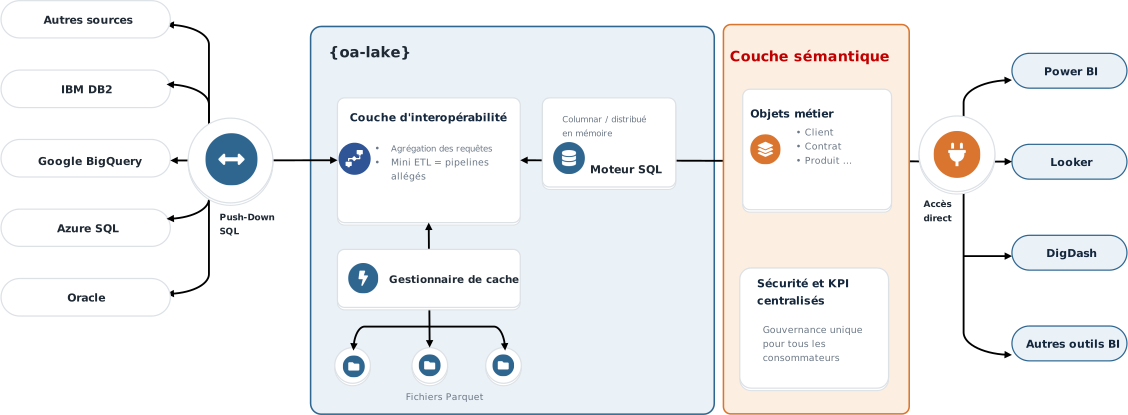
{oa-lake} se connecte simultanément aux bases relationnelles, data warehouses, lakehouses, fichiers ou APIs. Un moteur SQL distribué fédère les requêtes et exécute les jointures, calculs et transformations.
Contrairement à certaines couches sémantiques du marché, celle d’{oa-lake} ne nécessite ni modèle physique spécifique, ni table pivot, ni chemin de navigation imposé : les relations sont calculées dynamiquement à partir du modèle existant.
Sources de données
Les données restent dans leurs systèmes d’origine. Oracle, SQL Server, PostgreSQL, DB2, BigQuery, Snowflake, Redshift, Azure SQL (et autres) ou des fichiers peuvent être interrogés dans une même requête, et un même objet métier peut combiner plusieurs sources.
Le Push-Down SQL propage les requêtes et les filtres utilisateurs jusqu’aux systèmes existants, sans copie systématique des données.
Usage typique : construire un dashboard ou un KPI à partir de données réparties sur plusieurs plateformes, sans migration préalable.
Objets métier et couche sémantique
Les catalogues regroupent dimensions, mesures, KPI, hiérarchies et nomenclatures métier, organisés indépendamment des structures physiques des bases. Les relations entre objets sont définies dans la couche sémantique, qui devient le point d’entrée unique des outils de restitution : les règles de gestion ne sont plus dupliquées dans chaque plateforme.
Génération SQL
Le SQL est généré dynamiquement à partir des objets métier, dimensions, mesures et filtres sélectionnés ; jointures, agrégations et règles de calcul sont appliquées par le moteur. Ce SQL reste standard, portable et exécutable par tout moteur SQL compatible, ce qui limite le lock-in technologique.
Interface d’exploration
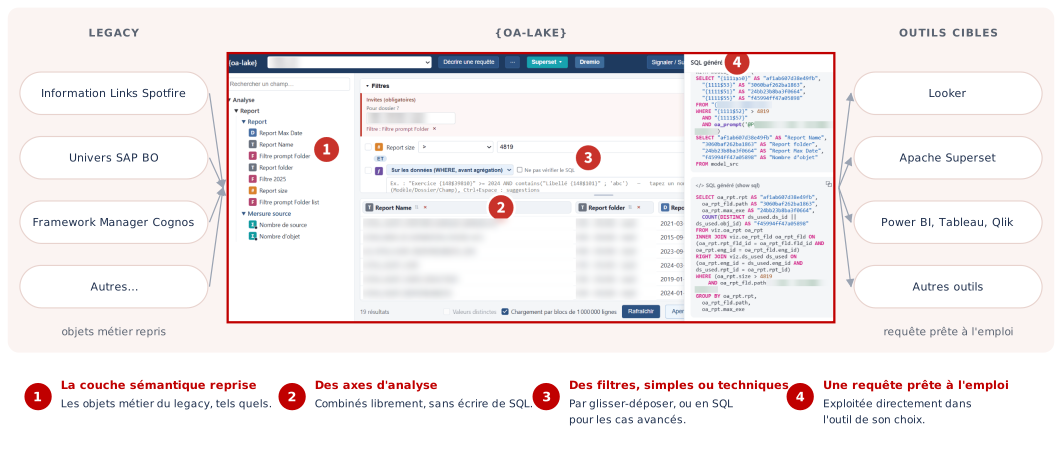
{oa-lake} est livré avec une interface d’exploration des couches sémantiques.
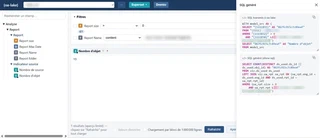
- Choix de la couche sémantique : la liste déroulante en haut à gauche donne accès aux catalogues disponibles.
- Sélection des objets métier : l’arborescence (dossiers, dimensions, mesures) est parcourue, puis les objets sont basculés à droite pour être affichés ou utilisés comme filtres.
- Exécution : un aperçu limité est proposé immédiatement ; la requête complète est lancée à la demande.
- Contrôle du SQL : le SQL transmis à {oa-lake} et le SQL physique généré sont consultables et copiables.
- Restitution : le résultat peut être basculé vers Superset, Dremio ou un autre outil de datavisualisation.
Couche sémantique reprise, multi-outils
Les objets métier du legacy (Information Links Spotfire, univers SAP BO, Framework Manager Cognos…) sont repris tels quels, et la requête générée alimente directement l’outil de son choix (Looker, Apache Superset, Power BI, Tableau, Qlik…).
Moteur SQL et cache
Les requêtes sont exécutées par un moteur SQL columnar et in-memory, ou propagées vers les systèmes sources selon le contexte. Les jeux de données les plus sollicités peuvent être matérialisés au format Parquet ; le Cache Manager pilote ce cache automatiquement selon les usages observés.
Usage typique : accélérer les traitements analytiques les plus coûteux sans modifier les systèmes sources.
Sécurité
Restrictions d’accès, profils utilisateurs, catalogues métier et filtres de sécurité sont gérés dans la couche sémantique et appliqués avant la génération des requêtes, pour tous les outils connectés. Les mécanismes de sécurité de SAP BusinessObjects ou IBM Cognos peuvent ainsi être reproduits.
Restitution et migration progressive
Tout outil capable d’interroger une source PostgreSQL ou SQL (Power BI, Looker, Spotfire, Tableau, Qlik, SAP BusinessObjects…) accède aux mêmes objets métier. Changer d’outil n’implique plus de reconstruire dimensions, mesures et règles de calcul, et plusieurs outils peuvent coexister pendant une phase de transition, sans modification des systèmes de données.
Gouvernance et data lineage
Les évolutions fonctionnelles sont réalisées dans la couche sémantique, puis immédiatement disponibles pour les outils connectés. Le data lineage reconstruit par {openAudit} couvre toute la chaîne, des systèmes sources jusqu’aux indicateurs des dashboards.
Questions fréquentes
Qu'est-ce qu'une couche sémantique indépendante des outils BI ?
Faut-il copier les données dans {oa-lake} ?
Quels outils BI peuvent se connecter à {oa-lake} ?
Peut-on changer d'outil de dataviz sans reconstruire les indicateurs ?
Comment la sécurité est-elle gérée dans {oa-lake} ?