Migration DataViz - SAP BO, Power BI, Spotfire ou Cognos vers une architecture ouverte et interopérable
SAP BusinessObjects, IBM Cognos, Power BI ou Spotfire se succèdent au sein d’un même Système d’Information, alors que les objets métier, calculs, indicateurs et règles de gestion restent généralement identiques d’une plateforme à l’autre. {openAudit} les extrait pour les reconstruire dans un format indépendant de la technologie cible.
Analyse du patrimoine décisionnel
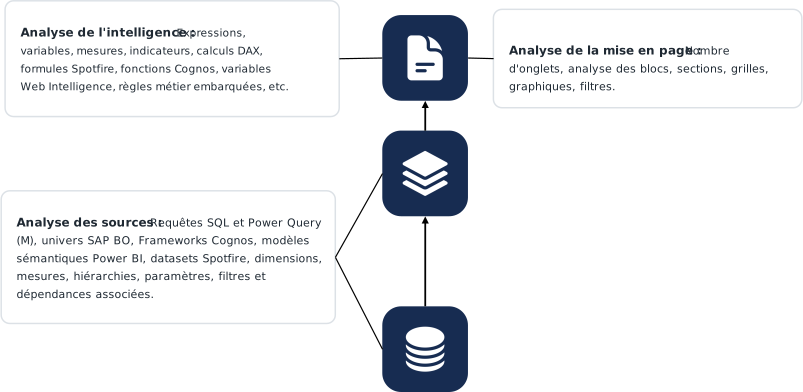
Des parsers analysent les univers SAP BusinessObjects, les Frameworks Cognos, les modèles Power BI, les Information Links Spotfire et les rapports, dashboards, calculs, filtres et objets métier associés. Les dépendances entre sources de données, traitements intermédiaires et objets exposés dans les dashboards sont reconstruites, avec les couches sémantiques et les règles de gestion.
Rationalisation
Le croisement avec les logs d’usage identifie rapports inutilisés, doublons et composants obsolètes avant migration.
Résultat : réduction du périmètre réellement migré.
Transcription SQL
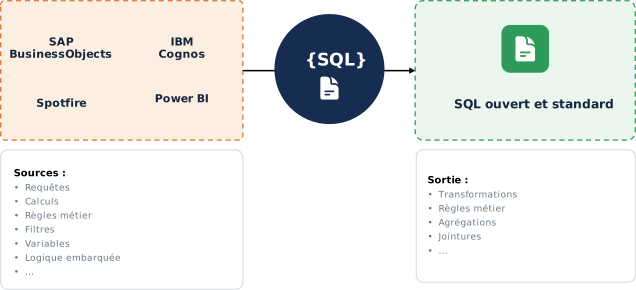
Requêtes, calculs, filtres, agrégations, jointures, variables et règles métier sont reconstruits en SQL, représentation ouverte de la logique portée par la plateforme de datavisualisation. Ce SQL est exécuté dans {oa-lake} sous forme de mini pipelines, et les objets métier des couches sémantiques sources alimentent sa couche sémantique interopérable (voir ci-dessous).
Point clé : le SQL devient le format pivot de représentation des objets métier.
{oa-lake} : le socle de toute migration DataViz
Migrer d’un outil de reporting à un autre répond au besoin immédiat, mais déplace la logique métier dans un nouveau modèle propriétaire : au prochain changement d’outil, tout est à reconstruire.
C’est pourquoi chaque migration DataViz s’appuie désormais sur le middleware {oa-lake}, qui joue deux rôles :
- Encapsuler l’intelligence. Les requêtes, calculs, variables et règles métier extraits par {openAudit} sont transcrits en SQL et exécutés dans {oa-lake} sous forme de mini pipelines SQL (un mini ETL), au lieu d’être réécrits dans l’outil cible.
- Préserver la couche sémantique. La couche sémantique construite au fil des années dans la plateforme source (univers, Frameworks, modèles) est reconstituée dans la couche sémantique interopérable d’{oa-lake}, qui alimente ensuite l’outil cible.
Quel que soit l’outil cible, il se connecte à {oa-lake} et consomme un modèle déjà prêt : objets métier, KPI et sécurité ne sont plus enfermés dans un nouveau modèle propriétaire.
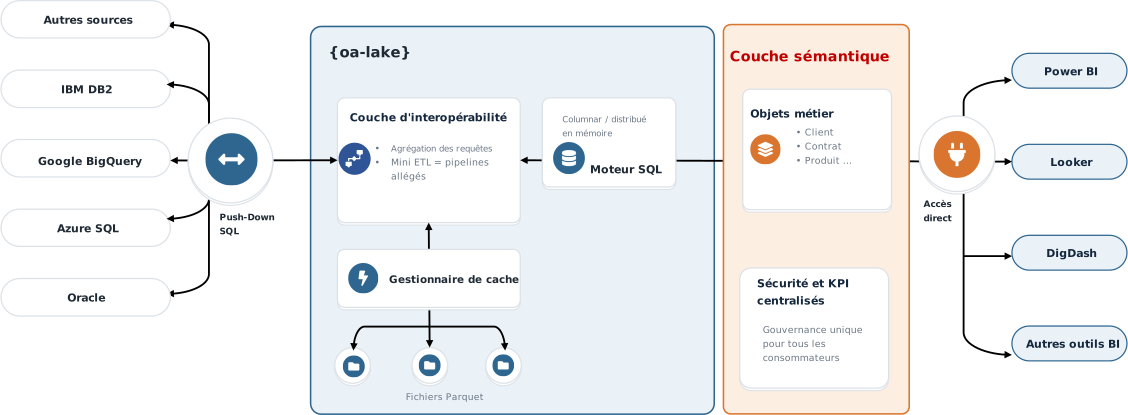
- Définir une fois, utiliser partout : client, contrat, produit… une seule définition, valable pour tous les outils consommateurs.
- KPI et sécurité centralisés : des indicateurs calculés une seule fois et une sécurité appliquée uniformément, quel que soit l’outil de restitution.
- Data prep rationalisée : des mini pipelines SQL mutualisés remplacent la préparation dispersée dans chaque outil.
- Outils BI interchangeables : Power BI, Looker, DigDash ou tout autre outil se connecte à un modèle déjà prêt, sans redéfinir la logique métier.
- Piloté comme du code : pipelines SQL et modèle sémantique en YAML/JSON, versionnés dans Git et déployés par Terraform.
- Prêt pour l’IA : les mêmes données et la même sémantique alimentent la BI, les LLM et les agents IA.
Point clé : migrer vers {oa-lake}, c’est migrer une dernière fois. La logique métier devient un actif de l’entreprise, indépendant des éditeurs.
Découvrir {oa-lake} → · Interopérabilité SQL et couche sémantique →
